A implementação ficou mais rápida. O julgamento, não necessariamente.
Em 19 de outubro de 2026, uma validação real expôs uma falha no Axiom, projeto open source que desenvolvo para organizar e governar fluxos de trabalho com agentes de inteligência artificial. O Codex estava instalado e a autenticação havia sido observada. Mesmo assim, a execução não começava.
O bloqueio tinha um nome: capability_unknown. O Axiom exigia uma certificação prévia das capacidades do agente — vinculada à versão, à identidade do executável, ao modo de execução e a outras condições — antes de permitir que ele trabalhasse. Como não havia os registros de prova exigidos para aquela combinação, a tentativa era recusada sem sequer verificar o comportamento real do Runtime.
Não era simplesmente um bug. Era a consequência previsível de uma decisão arquitetural que eu havia aprovado oito dias antes. Naquele momento, a exigência de certificação me pareceu uma garantia sensata. Agora ela impedia justamente a operação que o produto deveria viabilizar.
Vale explicar por que uma escolha assim parecia razoável. Se um sistema depende de outro programa para executar tarefas, soa prudente verificar antecipadamente se ele consegue realizar aquilo que promete. Se uma atualização alterar o comportamento desse programa, a comprovação anterior pode deixar de valer. A partir dessa preocupação, exigir novas provas antes de cada combinação de execução parece, à primeira vista, uma forma de reduzir incertezas.
Mas existe uma diferença entre reconhecer um risco e assumir a obrigação de eliminá-lo antes de qualquer tentativa. No caso concreto, o Axiom não estava descobrindo uma incompatibilidade do Codex; estava barrando a operação porque sua própria estrutura de certificação não conseguia apresentar as evidências exigidas. A garantia criada para permitir uma execução confiável passou a ser um obstáculo para descobrir se aquela execução funcionaria.
O episódio me obrigou a revisitar uma pergunta que vinha surgindo no meu trabalho: se a IA permite implementar muito mais coisas ao mesmo tempo, quem absorve o custo de compreender, questionar e autorizar tudo o que ela produz?
A questão não é se programadores devem deixar de revisar código. É se o modelo tradicional de concentrar no humano a revisão de cada decisão continua sustentável quando a produção pode ocorrer em várias frentes paralelas — e o que acontece quando a própria supervisão se torna um risco.
O que significa falar de carga cognitiva com IA?
Carga cognitiva não é sinônimo de cansaço, quantidade de código ou número de mensagens em uma conversa. Aqui, o termo se refere às exigências mentais de uma tarefa: manter informações relevantes em mente, compreender relações, avaliar alternativas e decidir. É importante distinguir o esforço percebido pelo profissional, o desempenho na tarefa, a fadiga ao longo do tempo e o custo de verificar um resultado. Essas medidas podem variar em direções diferentes.
Um exemplo simples ajuda. Imagine que eu precise escrever uma função cujo comportamento já conheço: quais entradas recebe, quais saídas deve produzir e como testá-la. Há trabalho envolvido, claro, mas boa parte das decisões já está resolvida. Posso gastar tempo digitando e depurando sem precisar rediscutir a arquitetura do sistema.
Agora imagine que três implementações diferentes cheguem prontas ao mesmo tempo. Em uma, preciso verificar se uma autorização foi preservada; em outra, avaliar se o contrato entre componentes mudou; na terceira, decidir se uma nova dependência cabe no escopo do produto. A digitação praticamente desapareceu, mas surgiram três julgamentos que exigem tipos diferentes de atenção. É uma ilustração, não uma medição: o ponto é mostrar por que quantidade de código produzido e esforço para decidir não são a mesma coisa.
A IA altera a distribuição desse trabalho. Uma implementação que antes exigia escrever arquivos, procurar interfaces e depurar cada detalhe pode chegar como um conjunto de alterações prontas. Mas o destinatário ainda precisa determinar se a solução corresponde ao requisito, respeita a arquitetura, introduz um comportamento indesejado ou compromete alguma restrição importante.
A resposta gerada pode ser extensa e convincente. Nenhuma dessas características a transforma automaticamente em uma decisão adequada.
Para examinar o problema, vale olhar separadamente para pesquisas sobre pensamento crítico, escrita assistida, programação, produtividade e supervisão. Elas não estudam o mesmo objeto nem autorizam uma conclusão universal.
O que os estudos encontraram — e onde discordam
1. O pensamento crítico pode mudar de lugar
Em The Impact of Generative AI on Critical Thinking (CHI 2025), Lee e colegas ouviram 319 trabalhadores do conhecimento, que relataram 936 exemplos de uso de IA generativa no trabalho. O estudo encontrou associação entre maior confiança na IA e menor exercício autorrelatado de pensamento crítico; maior confiança na própria capacidade apareceu associada a mais pensamento crítico. Os autores também observaram uma mudança na natureza das atividades relatadas: verificar informações, integrar respostas e supervisionar tarefas ganharam destaque.
É uma descrição próxima do que acontece na engenharia assistida por IA: o trabalho pode sair da produção direta e se concentrar na avaliação do que deve ser aceito. Mas há uma limitação decisiva: a pesquisa se baseia em relatos de participantes. Ela não demonstra que usar IA necessariamente reduz a capacidade de pensar, nem estabelece um efeito causal universal.
2. Verificar não é a mesma coisa que produzir
Yao e Fan desenvolveram e validaram, em pesquisa publicada em 2025, uma escala para investigar a carga cognitiva na escrita em segunda língua com IA. O processo de validação envolveu uma análise exploratória com 241 participantes e uma confirmatória com 305. O instrumento distingue quatro dimensões: gerenciamento de comandos, avaliação crítica, síntese integrativa e processamento autoral.
O interesse desse trabalho, para a nossa discussão, é metodológico. Ele ajuda a nomear esforços diferentes dentro de uma mesma interação. Não comprova, por si, que a IA aumente a carga mental dos engenheiros de software: o instrumento foi desenvolvido para um contexto educacional específico de escrita.
Em outra área, Yao e colaboradores (2026) estudaram a pós-edição de traduções assistidas por IA combinando rastreamento ocular, registros de edição, avaliações subjetivas e entrevistas. Os resultados relatados apontam redução da carga global em determinadas condições, ao mesmo tempo em que certas decisões exigem engajamento cognitivo localizado. Ou seja: é possível sentir menos esforço no conjunto da tarefa e ainda enfrentar momentos de julgamento particularmente exigentes. Traduzir textos não é projetar software, mas a distinção é útil.
3. Na programação, há ganhos reais e custos de verificação
Um experimento de Fan e colegas, apresentado na CHI 2026, comparou formas de interação com o mesmo modelo de IA em 60 participantes realizando três tarefas em Python, além de uma condição sem IA. No contexto estudado, a assistência reduziu a carga de trabalho percebida em 18,2 pontos na escala utilizada, diminuiu o tempo de conclusão em cerca de 22% e melhorou a correção das soluções. Isso contraria a ideia de que usar IA necessariamente torna o trabalho mais pesado.
O mesmo experimento, porém, mediu um componente específico: o custo comportamental de verificar a saída, considerando falhas, tempo até a primeira compilação, retrabalho, pausas e alternâncias. Esse indicador ajudou a explicar parte da evolução da fadiga e do estresse ao longo de tarefas repetidas. As modalidades de interação também tiveram desempenhos diferentes segundo a complexidade e a experiência dos participantes.
Para visualizar essa diferença sem confundi-la com o experimento, pense numa tarefa que a IA consiga implementar rapidamente. A maior parte das alterações pode estar correta e economizar tempo. Ainda assim, um único detalhe inesperado — por exemplo, uma mudança na forma como um processo trata permissões — pode exigir uma pausa, leitura de documentação e comparação entre alternativas. A tarefa inteira pode continuar sendo mais rápida, mesmo que aquele momento específico de verificação seja exigente.
Também existe o caminho inverso. Quando os requisitos são claros e os testes conseguem conferir a maior parte do comportamento, a revisão pode ficar mais simples junto com a implementação. Por isso, dizer que a IA acelera ou sobrecarrega, sem explicar o tipo de atividade e como ela foi verificada, esconde parte importante do problema.
Não devemos transportar esses percentuais diretamente para projetos longos, múltiplos agentes ou decisões arquiteturais. O valor do estudo está em mostrar que resultado, duração, carga geral e esforço de verificação precisam ser avaliados separadamente.
4. Produtividade percebida pode divergir da medida
Em um experimento randomizado publicado pela METR em 2025, 16 desenvolvedores experientes executaram 246 tarefas em repositórios open source que conheciam bem. Naquele cenário e com aquelas ferramentas, a assistência de IA fez as tarefas demorarem, em média, 19% mais. Antes do experimento, os participantes previam ganhos; depois, continuaram percebendo ganhos mesmo com o resultado medido na direção oposta.
O achado é relevante para quem confunde geração acelerada de código com entrega acelerada de software. Entretanto, ele registra um conjunto específico de ferramentas e tarefas de 2025. Os próprios pesquisadores alertaram em fevereiro de 2026 que os resultados históricos estavam ficando desatualizados e que o estudo posterior apresentava vieses de seleção e incertezas de medição, especialmente com agentes em paralelo. Não seria correto usar os 19% como retrato do desenvolvimento assistido em outubro de 2026.
Uma investigação de campo divulgada em setembro de 2026, com 21 desenvolvedores em dois locais da SAP durante quatro dias, também reforça a importância do contexto concreto da tarefa ao avaliar carga percebida. Trata-se, porém, de um estudo pequeno e divulgado como preprint, não de uma resposta definitiva.
5. O gargalo pode se deslocar do indivíduo para o processo
No State of Developer Experience 2026, a Atlassian reuniu respostas de mais de 1.500 profissionais de software. Entre os resultados, 87% afirmaram que a IA os ajuda a entregar trabalho mais rapidamente, mas apenas 28% relataram sentir significativamente menos atrito no fluxo diário. 49% disseram dedicar quatro ou mais horas por semana a atividades como revisar resultados de IA e corrigir comandos; 75% relataram maior responsabilidade por validar qualidade e segurança.
São respostas de uma pesquisa com profissionais, não cronômetros nem um experimento causal. Ainda assim, fazem sentido ao lado dos estudos anteriores: acelerar uma etapa não garante acelerar o sistema inteiro.
O relatório DORA 2025 chega a uma conclusão sistêmica relacionada: a IA tende a amplificar características já existentes nas organizações, tanto práticas saudáveis quanto fragilidades de entrega. A velocidade local não dispensa qualidade das especificações, testes, feedback e coordenação.
A síntese possível até aqui é limitada, mas consistente: existem ganhos demonstrados em vários cenários; também existem custos mensuráveis e percebidos de verificação. A pergunta correta não é se a IA sempre ajuda ou sempre sobrecarrega. É em quais condições, para quais tarefas e com quais mecanismos de supervisão ela melhora o resultado completo.
Figura 1 — Produzir não é o mesmo que validar. O esquema ilustra duas frentes de avaliação que podem existir após uma implementação gerada por IA; não representa uma medição dos estudos citados.

flowchart TD
    A["IA pode acelerar a produção"] --> B["Implementações e alternativas prontas"]
    B --> C["Verificações objetivas<br>Testes, requisitos e contratos"]
    B --> D["Julgamento contextual<br>Produto, arquitetura e escopo"]
    C --> E["Aceitar, corrigir ou investigar"]
D --> EMeu experimento involuntário: mais implementações, mais decisões
Nos últimos meses, a IA mudou a minha rotina. Deixei de gastar tanto tempo implementando diretamente e passei a conduzir mais atividades em paralelo. Isso ampliou o volume de resultados disponíveis para minha análise. O que não cresceu na mesma proporção foi minha capacidade de avaliar alternativas arquiteturais, impactos no produto e decisões inesperadas.
O tipo de situação que passei a enfrentar fica mais fácil de entender quando colocamos as frentes lado a lado. Uma implementação pode retornar uma dúvida sobre a arquitetura; outra pode chegar com uma alternativa de experiência do produto; uma terceira pode sugerir algo que amplia o escopo inicialmente combinado. Cada pergunta isolada parece administrável. O problema começa quando todas exigem uma avaliação cuidadosa antes que os trabalhos avancem.
Não se trata apenas de ler três respostas. Em cada uma, preciso decidir se conheço o assunto o suficiente, se existe alguma premissa nova e até onde aquela escolha pode repercutir. E, se uma delas me obriga a investigar com profundidade, as outras não deixam de existir. Essa simultaneidade é parte do que tornou o volume de decisões pesado para mim.
O problema mais difícil não era recuperar o contexto de uma tarefa. Muitas vezes, isso estava documentado. Era receber um novo detalhe, perceber que ele alterava uma premissa e precisar entender suas consequências em profundidade antes de autorizar o próximo passo. Em cada frente, havia questões sobre desenho da solução, responsabilidades, compatibilidade, riscos e escopo. O acúmulo tornava o processo mais estressante.
Tentei melhorar a apresentação das respostas. Passei a pedir à IA um mapa das decisões que realmente precisava tomar, com linguagem simples, sem siglas obscuras, sem abreviações que me obrigassem a decodificar o contexto e com explicações executivas de um ponto por vez. Isso ajudou a consumir a informação, mas não resolveu o volume de decisões.
Na prática, eu queria deixar de receber uma explicação longa com cinco assuntos misturados e passar a enxergar o que precisava resolver primeiro. Um mapa poderia separar, por exemplo, uma decisão que altera a arquitetura, outra que muda o escopo e uma terceira que é apenas um detalhe de implementação. Em seguida, a IA apresentaria uma delas em linguagem direta, explicando o que está em jogo e qual seria o impacto de cada caminho. Esse é um exemplo do formato que busquei, não a transcrição de uma resposta específica.
Isso melhorou a forma de consumir as informações. Só que organizar dez decisões em uma lista mais legível não transforma dez decisões em duas. Eu conseguia entender melhor o que estava sendo pedido, mas continuava precisando investigar os trade-offs e autorizar os próximos passos. A interface estava mais clara; a responsabilidade continuava concentrada em mim.
Foi aí que comecei a mudar a pergunta. Em vez de tentar revisar tudo de maneira mais eficiente, passei a questionar por que tudo precisava da minha decisão.
O caso Axiom: quando uma garantia virou bloqueio
A história das Runtime Capabilities permite sair da percepção e observar os artefatos de engenharia.
A preocupação inicial era legítima: não bastava saber que Codex ou Claude estava instalado e autenticado. Como garantir que um Runtime conseguia ler arquivos, escrever, iniciar processos ou operar sem interação manual? A resposta escolhida foi instituir um mecanismo de prova comportamental prévia. A ADR-0025, aceita em 11 de outubro, fixou essa diretriz. A verificação exigiria evidências associadas à identidade exata da execução, com validade e revalidação.
Considere duas perguntas diferentes. A primeira é: “O Runtime está instalado, configurado e autorizado a atuar neste projeto?” A segunda é: “Conseguimos demonstrar antecipadamente que esta versão exata do Runtime realizará cada operação prevista?” A primeira permite controlar quem pode operar e sob quais condições. A segunda exige que a plataforma mantenha um mecanismo próprio para certificar comportamentos de um software de terceiros.
Foi essa segunda responsabilidade que o Axiom assumiu. No papel, ela oferecia uma segurança adicional. Na operação, trazia outras obrigações: identificar a versão e o executável, produzir evidências, determinar por quanto tempo seriam válidas e bloquear uma execução quando essas comprovações não estivessem disponíveis. Não é que esses cuidados sejam sempre inúteis. A pergunta é se eram proporcionais ao problema que um MVP precisava resolver naquele momento.
Nas semanas anteriores, o projeto já havia formalizado políticas de seleção de Runtime e perfis; entre 11 e 16 de outubro, diferentes pull requests implementaram partes da certificação, da seleção de evidências e do disparo de etapas. O PR #320 registrava testes com Runtimes e evidências sintéticas, não uma validação completa com agentes reais.
Na validação real de 19 de outubro, relatada em AXM-12, o Axiom v0.20.0 encontrou o Codex CLI 0.163.0 com autenticação observada, mas recusou a execução por capability_unknown em seis capacidades. A exigência de registros e provas, inclusive um registro de versões que estava vazio, barrava a tentativa antes da operação. A falha não demonstrava que o Codex fosse incapaz de executar; demonstrava que faltava a certificação exigida pelo próprio Axiom.
A nova direção foi formalizada em AXM-36 e na ADR-0032. Em vez de assumir a responsabilidade de certificar antecipadamente cada versão e combinação de um fornecedor, o Axiom passaria a inspecionar, autorizar, executar, observar e diagnosticar. O PR #334, incorporado em 20 de outubro, retirou os componentes ativos de prova obrigatória. O PR #339 corrigiu regressões de testes detectadas posteriormente, e a mudança integrou a v0.21.1.
É fundamental não reduzir essa revisão a “abrimos mão de segurança”. As políticas de seleção, o controle de autoridade, as permissões, os vínculos de identidade, a supervisão e as regras de recuperação foram preservados. A própria ADR-0032 explicita o novo trade-off: algumas falhas só aparecem quando uma execução autorizada é tentada, exigindo diagnóstico confiável e cuidado com efeitos incertos.
A mudança foi também uma correção de fronteira de responsabilidade: o Axiom continuaria responsável por autorizar e controlar o que lhe cabe; não precisaria garantir antecipadamente todo o comportamento interno de cada versão de um agente de terceiros.
Figura 2 — A execução de Runtime antes e depois da revisão arquitetural do Axiom. O primeiro trecho representa o bloqueio observado em 19/10; o segundo representa o contrato adotado pela ADR-0032, não uma comprovação de compatibilidade real do fornecedor.
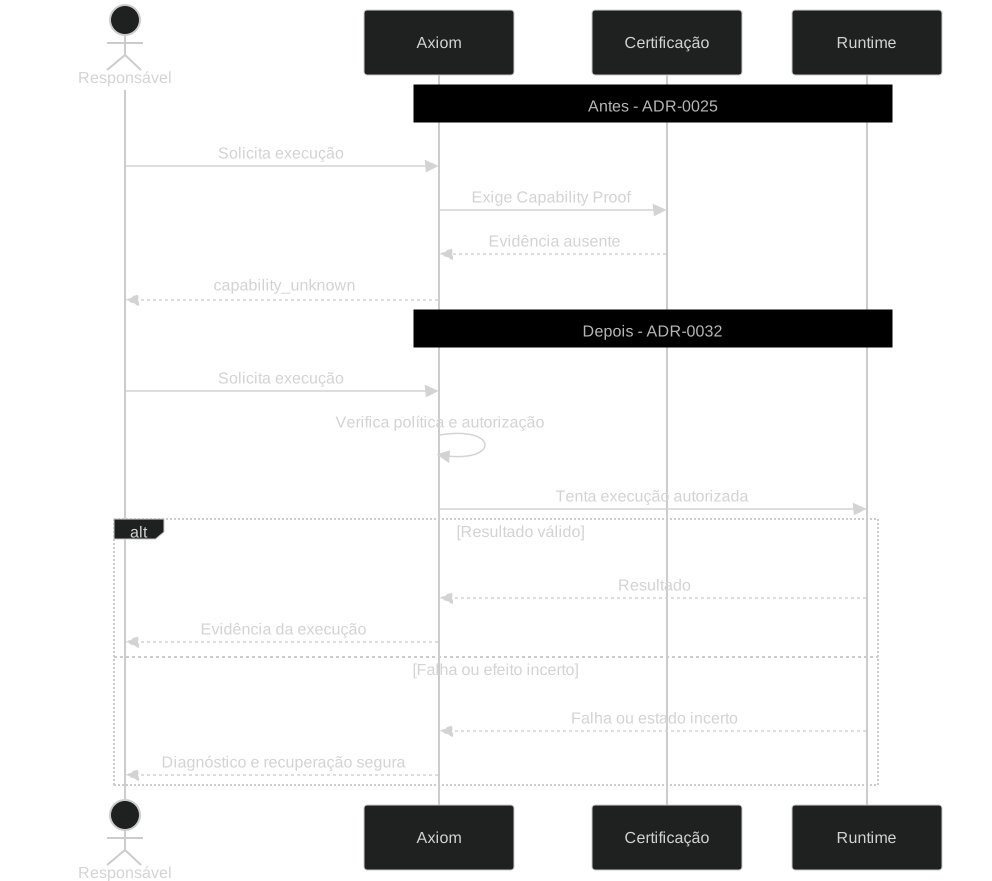
sequenceDiagram
    actor P as Responsável
    participant A as Axiom
    participant C as Certificação
    participant R as Runtime
    Note over A,R: Antes - ADR-0025
    P->>A: Solicita execução
    A->>C: Exige Capability Proof
    C-->>A: Evidência ausente
    A-->>P: capability_unknown
    Note over A,R: Depois - ADR-0032
    P->>A: Solicita execução
    A->>A: Verifica política e autorização
    A->>R: Tenta execução autorizada
    alt Resultado válido
        R-->>A: Resultado
        A-->>P: Evidência da execução
    else Falha ou efeito incerto
        R-->>A: Falha ou estado incerto
        A-->>P: Diagnóstico e recuperação segura
endA decisão que eu aprovei — e o que não percebi naquele momento
O histórico do repositório permite comprovar a decisão, a implementação e a reversão. A explicação da minha experiência, por outro lado, é uma interpretação retrospectiva e precisa ser reconhecida assim.
Quando aprovei a certificação em 11 de outubro, eu já sentia dificuldade de acompanhar o volume e a densidade das decisões. Havia várias frentes acontecendo em paralelo. A proposta parecia tecnicamente positiva: mais garantias, mais previsibilidade, menos risco. Eu não parei para dimensionar suficientemente o que significava transformar a certificação de capacidades em responsabilidade estrutural do produto.
É importante traduzir o tamanho daquela aprovação. Eu não estava apenas concordando com uma verificação a mais antes de iniciar um processo. A decisão acabou envolvendo um registro de versões e identidades, provas comportamentais, regras de validade, integração com perfis de execução e pontos de bloqueio ao longo do fluxo. Cada peça tinha uma justificativa técnica; juntas, criavam uma responsabilidade estrutural que precisaria continuar funcionando a cada mudança de versão ou de configuração.
Olhando agora para o histórico, eu consigo identificar essas implicações com muito mais nitidez do que conseguia naquele momento. Isso não significa que elas estivessem escondidas na documentação. Significa que, com tantas decisões acontecendo em paralelo, eu não dediquei a atenção necessária para questionar se o conjunto inteiro fazia sentido para a etapa do produto.
Também existia a ansiedade de entregar o produto mínimo viável, o MVP. Eu queria ver o Axiom funcionando de ponta a ponta. A combinação de pressa para avançar, muitas decisões simultâneas e soluções tecnicamente elaboradas diminuiu, na minha avaliação atual, a profundidade com que analisei aquela escolha.
Hoje considero a arquitetura do Axiom inflada para o estágio de MVP. Isso não equivale a dizer que seja uma arquitetura ruim em qualquer circunstância. Parte das garantias pode fazer sentido em um produto consolidado e com outras exigências operacionais. Mas exigir tudo isso antes de validar integralmente o fluxo central teve custo. Continuo trabalhando sobre essa arquitetura porque ela já existe e é mantível; não pretendo propor uma refatoração geral apenas por elegância.
Esse diagnóstico não pode ser confundido com prova científica de que sobrecarga cognitiva causou o erro. Pode haver explicações concorrentes: requisitos ainda em formação, preocupação legítima com segurança, pouca validação real naquele estágio e uma escolha de produto que só demonstrou sua inadequação no uso. O que posso afirmar em primeira pessoa é que a sensação de excesso decisório já estava presente e reconheço nela um fator plausível para a maneira como avaliei o risco.
O ponto incômodo é que a grande refatoração surgiu quando eu ainda buscava participar de praticamente todas as decisões. Mais supervisão, naquele caso, não garantiu uma escolha melhor.
Da revisão de tudo à autonomia dentro de limites
A mudança que comecei a aplicar no Axiom não foi simplesmente confiar mais na IA. Foi definir com mais clareza o que não pode ser decidido sem mim.
Procuro reservar intervenção humana para decisões de produto, arquitetura, design da experiência e mudanças que ampliem o escopo acordado. Quando objetivos, restrições e contratos estão claros, a IA pode resolver detalhes de implementação sem me consultar a cada passo. Se uma solução conflita com uma diretriz arquitetural, amplia o escopo ou exige assumir um risco relevante, a decisão volta para mim com o contexto específico da exceção.
Imagine um ajuste visual pequeno dentro de um padrão de design já definido. Se a IA altera um espaçamento ou uma mensagem de interface sem mudar requisitos, contrato ou comportamento relevante, é razoável que ela implemente e que eu confira a experiência no resultado final. Se não ficar bom, a correção tende a ser localizada. Este é um exemplo de decisão de baixo impacto, não um relato de uma alteração específica.
Compare com uma proposta de mudar a forma como o sistema autoriza a execução de agentes ou de introduzir uma nova responsabilidade em um componente central. Mesmo que o código pareça simples, ali já existe uma decisão arquitetural. Nesse caso, eu preciso entender o motivo, as alternativas e as consequências antes de aprovar. Dar autonomia para o primeiro tipo de escolha não significa liberar o segundo sem supervisão.
Na etapa final, eu testo o comportamento da implementação e avalio a experiência do produto. Frequentemente encontro ajustes pontuais: algo que poderia ficar mais simples, uma experiência que precisa ser refinada, um detalhe que não corresponde exatamente ao esperado. Aceito esse tipo de correção posterior quando o efeito é localizado, reversível e de baixo impacto.
Há um trade-off explícito. Alguma violação pode passar despercebida. Uma decisão aparentemente pequena pode revelar consequências maiores ou se acumular com outras. Para riscos de segurança, perda de dados, quebra de contratos, alterações arquiteturais amplas ou efeitos difíceis de reverter, não basta delegar e verificar quando der: são necessárias autorizações prévias, validações independentes e controles proporcionais ao impacto.
Ainda assim, na minha experiência até aqui, o fluxo mais autônomo não produziu uma refatoração de dimensão comparável à da certificação de Runtime. Isso não é uma comparação controlada de produtividade ou qualidade; é um resultado observado em um projeto específico.
O que mudou foi a distribuição das decisões. Em vez de tratar toda dúvida técnica como uma reunião obrigatória comigo, passei a concentrar atenção nas fronteiras que definem o produto e a arquitetura. O objetivo não é reduzir o julgamento humano a zero. É preservar julgamento humano onde ele agrega mais valor e onde errar custa mais.
A síntese: o custo que importa não é só revisar código
O caso do Axiom oferece um exemplo do problema estudado, mas também amplia a pergunta. A verificação não consiste apenas em procurar bugs em uma alteração. Ela inclui decidir se uma solução é necessária, se corresponde ao estágio do produto, se o risco vale a complexidade acrescentada e se uma garantia deveria ser responsabilidade daquele sistema.
Da comparação entre pesquisas e experiência, proponho três distinções:
Primeira: implementar mais rápido não significa entregar melhor. Uma etapa pode acelerar enquanto testes, integração, supervisão e revisão arquitetural passam a concentrar o trabalho. É preciso observar o fluxo completo — não contar arquivos, linhas de código, agentes ativos ou propostas aprovadas.
Segunda: reduzir carga de trabalho total não impede picos de esforço decisório. Os estudos que encontram ganhos são tão importantes quanto os que medem custo de verificação. Uma pessoa pode terminar tarefas mais depressa, mas gastar atenção crítica em episódios mais complexos e frequentes. Também pode ocorrer o contrário: uma boa interface e verificações automatizadas podem diminuir ambos.
Terceira: a presença humana não é uma garantia automática. Uma pessoa saturada, obrigada a decidir dezenas de questões heterogêneas, pode aprovar uma solução inadequada. Isso não justifica delegação irrestrita: exige desenhar fronteiras entre autonomia operacional, decisões de produto, limites arquiteturais e riscos inaceitáveis.
Como hipótese de engenharia, eu chamaria isso de governança da atenção: especificar decisões que exigem autoridade humana, automatizar verificações objetivas e reservar análise profunda para exceções de impacto. É uma proposta prática derivada da minha experiência, não um modelo científico validado.
Para avaliá-la de maneira mais séria, faria sentido medir, ao longo do tempo, quantas decisões chegam ao responsável, quantas exigem investigação nova, quantas interrupções poderiam ser evitadas, quantas violações escapam, quanto retrabalho surge depois e como evoluem qualidade, tempo de entrega e carga percebida. Sem essas medidas, qualquer afirmação de ganho permanece provisória.
Conclusão: o futuro do engenheiro não pode ser uma fila infinita de aprovações
Comecei esta investigação tentando entender se a IA havia trocado o esforço de implementar pelo esforço de verificar. A literatura indica que essa troca pode acontecer, mas não é obrigatória nem uniforme. Há ganhos concretos de tempo e redução de carga em alguns cenários; há custos de supervisão, fadiga, atrito de integração e até resultados mais lentos em outros. A diferença depende do tipo de trabalho, da experiência, das ferramentas e, principalmente, do processo em que a IA está inserida.
Minha experiência no Axiom acrescenta uma preocupação. Não basta aumentar a capacidade de geração se a pessoa responsável pelo produto continua sendo convocada a julgar cada decisão. O resultado pode ser uma arquitetura mais elaborada do que o momento exige — não necessariamente porque uma decisão foi absurda isoladamente, mas porque a soma de decisões razoáveis pode fugir do objetivo inicial.
No meu caso, existe ainda o contexto da pressa para ver o MVP funcionando. Cada garantia adicional tinha uma boa intenção: evitar uma falha, tornar uma execução previsível, impedir um comportamento desconhecido. O problema é que boas intenções não bastam para dizer se uma garantia pertence à primeira versão do produto. Algumas podem ser necessárias desde o início; outras podem ser incorporadas quando o sistema tiver demanda e maturidade para justificá-las.
Em retrospecto, foi assim que comecei a enxergar o “Megazord” que construímos. Não como uma única decisão absurda, mas como a soma de componentes, contratos e proteções que pareciam defensáveis separadamente. A arquitetura continuou mantível, e nem tudo o que foi criado é inútil. Mas a combinação ampliou a complexidade que precisávamos compreender justamente na fase em que nossa maior ansiedade era validar o funcionamento do produto.
O mecanismo de certificação de Runtime não era uma ideia sem fundamento. Havia uma intenção de segurança compreensível. O erro, na minha avaliação retrospectiva, foi aceitar aquele nível de garantia e responsabilidade como pré-condição para um MVP, sem avaliar suficientemente seu custo e sua aderência ao problema que precisávamos resolver naquele momento. A refatoração posterior corrigiu essa fronteira sem abandonar os controles fundamentais.
Hoje prefiro estabelecer o objetivo, explicitar as restrições, dar autonomia para escolhas reversíveis e exigir minha participação nas decisões de produto, arquitetura, escopo e risco relevante. Depois, verifico o comportamento real da entrega. Não considero esse método infalível; considero-o mais coerente com a capacidade de atenção de uma pessoa e com o estágio atual do projeto.
A pergunta, portanto, deixou de ser “quanto código a IA consegue escrever?” e passou a ser “quantas decisões relevantes conseguimos tomar bem — e quais delas realmente precisam de nós?”
Talvez a maior contribuição da IA para a engenharia não venha de produzir um volume ilimitado de soluções, mas de ajudar a criar sistemas de trabalho em que a atenção humana seja aplicada com critério. A automação deve ampliar nossa capacidade de entregar valor, não transformar o engenheiro em gargalo permanente de uma fila de aprovações.
Referências e evidências
Pesquisa científica e estudos empíricos
- Lee, H.-P. et al. (2025). The Impact of Generative AI on Critical Thinking — CHI 2025. Survey de trabalhadores do conhecimento; autorrelato, sem inferência causal.
- Yao, G.; Fan, L. (2025). Cognitive load scale for AI-assisted L2 writing — Frontiers in Psychology. Desenvolvimento e validação de instrumento; não mede o efeito causal sobre engenheiros.
- Yao, Y. e colaboradores (2026). Assistance or Distraction? — International Journal of Human–Computer Interaction. Pós-edição de tradução; contexto distinto de software.
- Fan, G. et al. (2026). When Help Hurts: Verification Load and Fatigue with AI Coding Assistants — CHI 2026. Experimento com 60 participantes e tarefas limitadas em Python.
- Becker, J. et al. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity — METR. Experimento randomizado; resultados datados, com atualização metodológica da METR em 2026.
- Brandebusemeyer, C. et al. (2026). Beyond Productivity: Measuring Developers’ Cognitive Load During GenAI-Supported Software Development. Preprint de estudo de campo, com amostra pequena.
- Atlassian (2026). State of Developer Experience Report 2026. Survey de mercado; medidas declaradas, não experimento.
- DORA / Google (2025). State of AI-assisted Software Development. Pesquisa organizacional, com análise de fatores sistêmicos.
- Romeo, G.; Conti, D. (2025/2026). Exploring automation bias in human–AI collaboration. Revisão sobre confiança excessiva e mecanismos cognitivos em decisões assistidas por IA.
Estudo de caso público: Axiom
- ADR-0025 — decisão original de Capability Proof e comentário D-1.
- PR #320 — dispatch com testes sintéticos.
- AXM-12 — validação operacional real e AXM-36 — revisão de produto.
- ADR-0032 — decisão sucessora e alternativas e Specification AXM-36.
- PR #334 — remoção da certificação, PR #339 — correções posteriores e release v0.21.1.